

A Pontuação de Chamada foi concebida para ajudar as equipas a melhorar a qualidade das chamadas sem acrescentar trabalho manual. Depois de cada conversa, as chamadas são avaliadas automaticamente com base num modelo de pontuação. Este guia explica como a funcionalidade funciona, como as pontuações são calculadas e como os supervisores e os agentes podem utilizar os resultados para um coaching mais rápido e mais consistente.
A Pontuação de Chamada avalia automaticamente cada chamada elegível e fornece feedback rápido e consistente. O sistema utiliza um modelo definido pela empresa para pontuar partes essenciais de uma conversa (por exemplo: Descoberta e Análise de Necessidades, Proposta de Valor e Adequação da Solução, Gestão de Objeções, etc.), acrescenta explicações escritas curtas e anexa excertos da transcrição como evidência. Isto ajuda os supervisores a concentrarem-se nas chamadas que precisam de revisão humana, enquanto os agentes recebem momentos rápidos de coaching depois de cada chamada.
Pré-requisitos
- Acesso de Administrador à Inteligência Conversacional de IA
- Pelo menos um modelo de pontuação configurado
- CI Plus para a atribuição automática do modelo de pontuação por grupo (chamadas atendidas por agentes humanos). A atribuição automática por Voice Agent está incluída nos AI Voice Agents e não exige qualquer plano CI.
Configuração
1. Aceda a Definições > Conversation Intelligence 2. Ative a opção Pontuação de Chamada. Em Modelos de pontuação, clique em Novo modelo de pontuação ou em Editar num modelo existente. A lista mostra cada modelo com o respetivo número de perguntas, um selo Padrão no modelo predefinido e as respetivas atribuições. O contador mostra quantos dos 10 modelos estão a ser utilizados.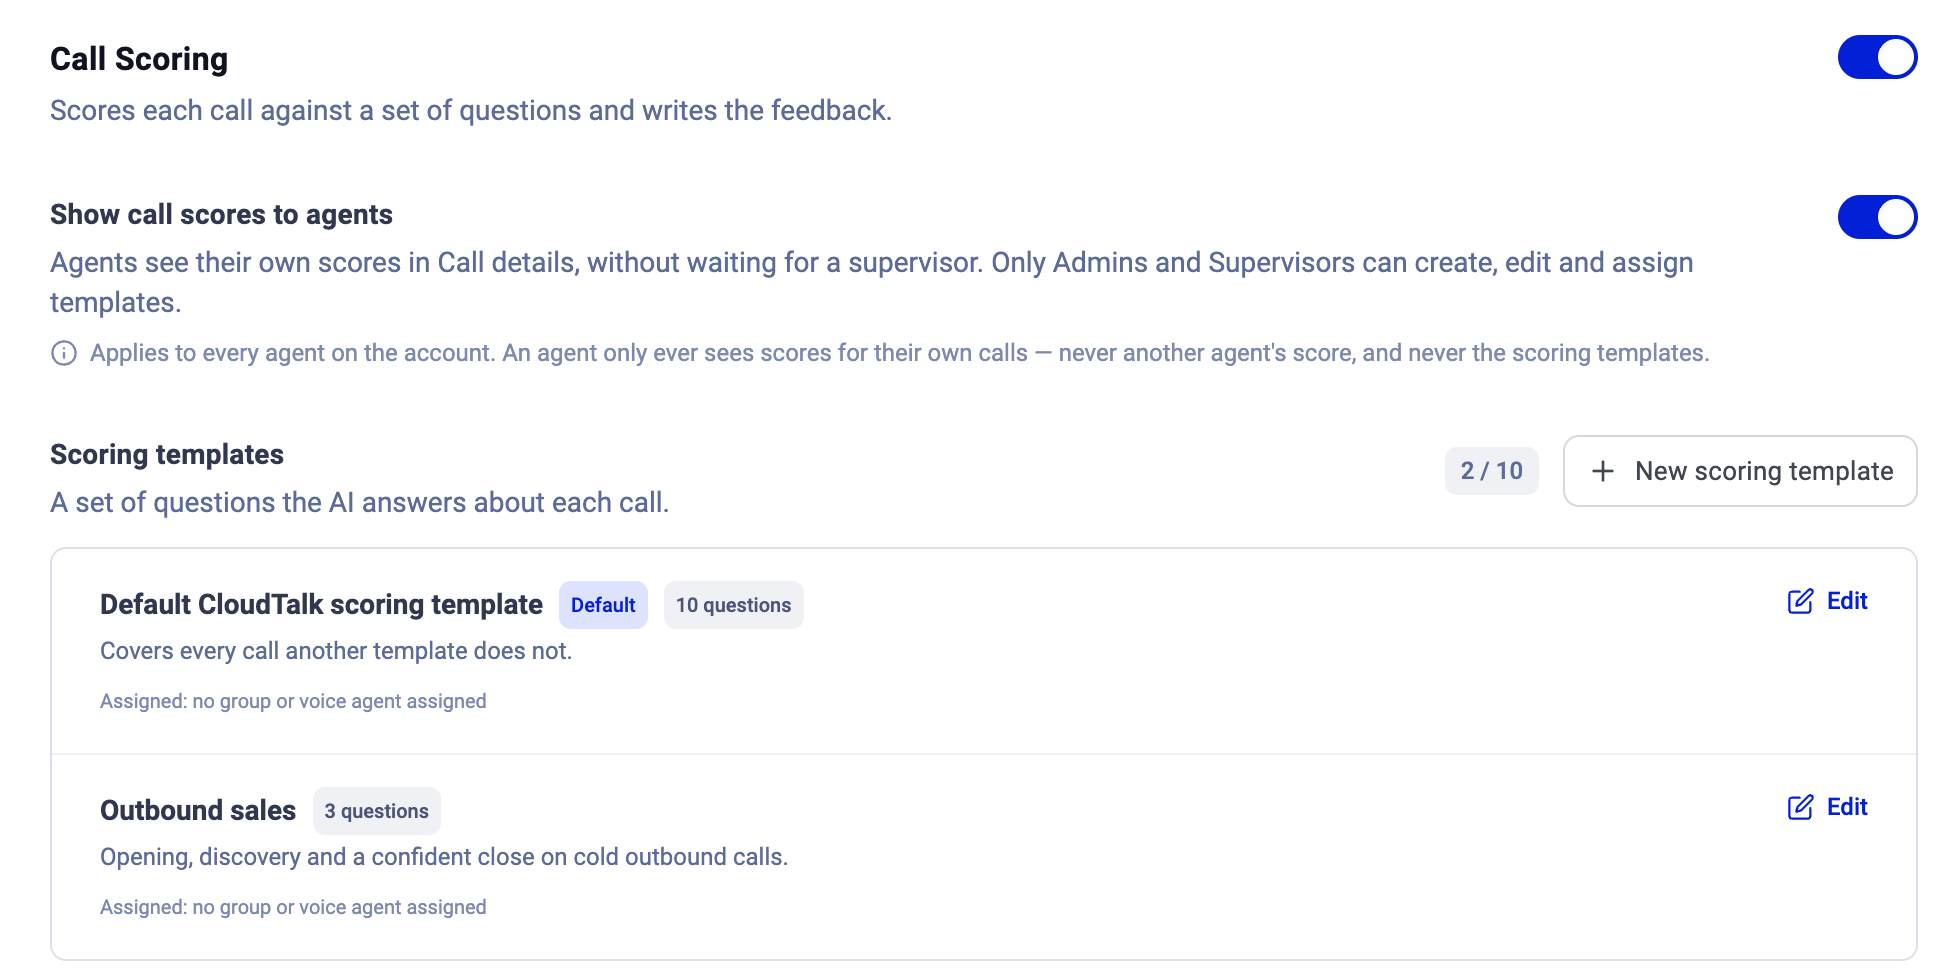
-
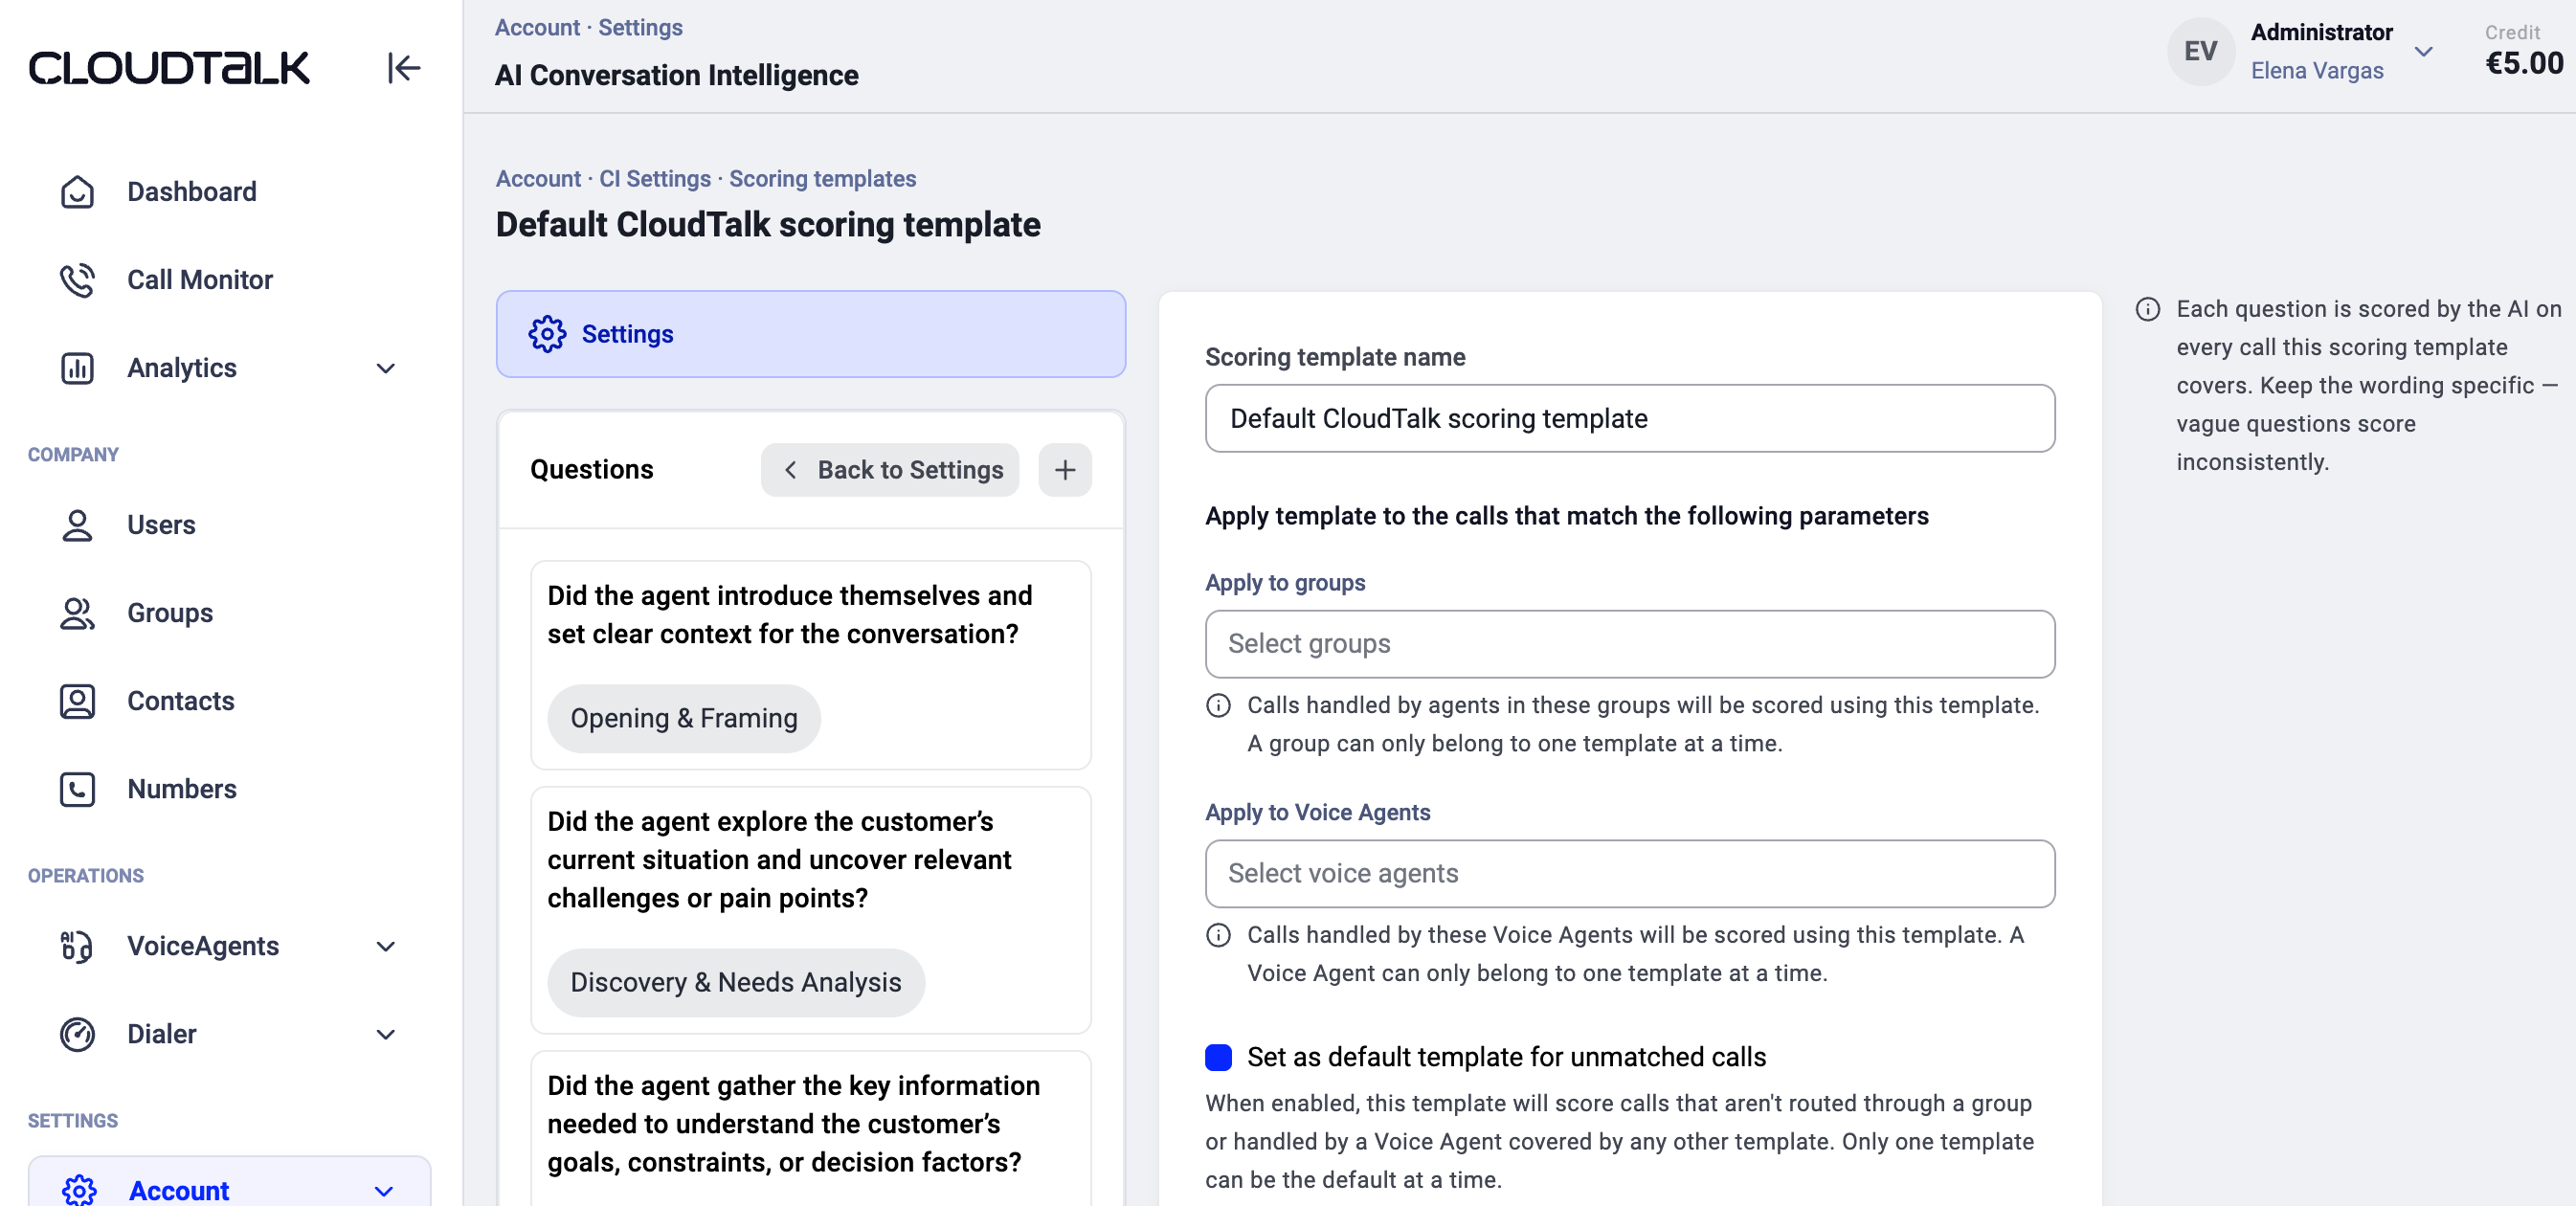
O editor tem duas partes: Definições (nome do modelo, Aplicar a grupos, Aplicar a Voice Agents, Definir como modelo padrão para chamadas sem correspondência) e Perguntas (a lista de perguntas, cada uma identificada com a respetiva categoria;
+adiciona uma pergunta). - As Categorias são fixas (Abertura e Enquadramento, Descoberta e Análise de Necessidades, Proposta de Valor e Adequação da Solução, Gestão de Objeções, Fecho e Próximos Passos, Tom e Empatia).
- Dentro de cada categoria, pode adicionar, remover ou editar perguntas.
- Para adicionar: escolha na biblioteca de perguntas predefinidas e depois edite o texto/os detalhes.
-
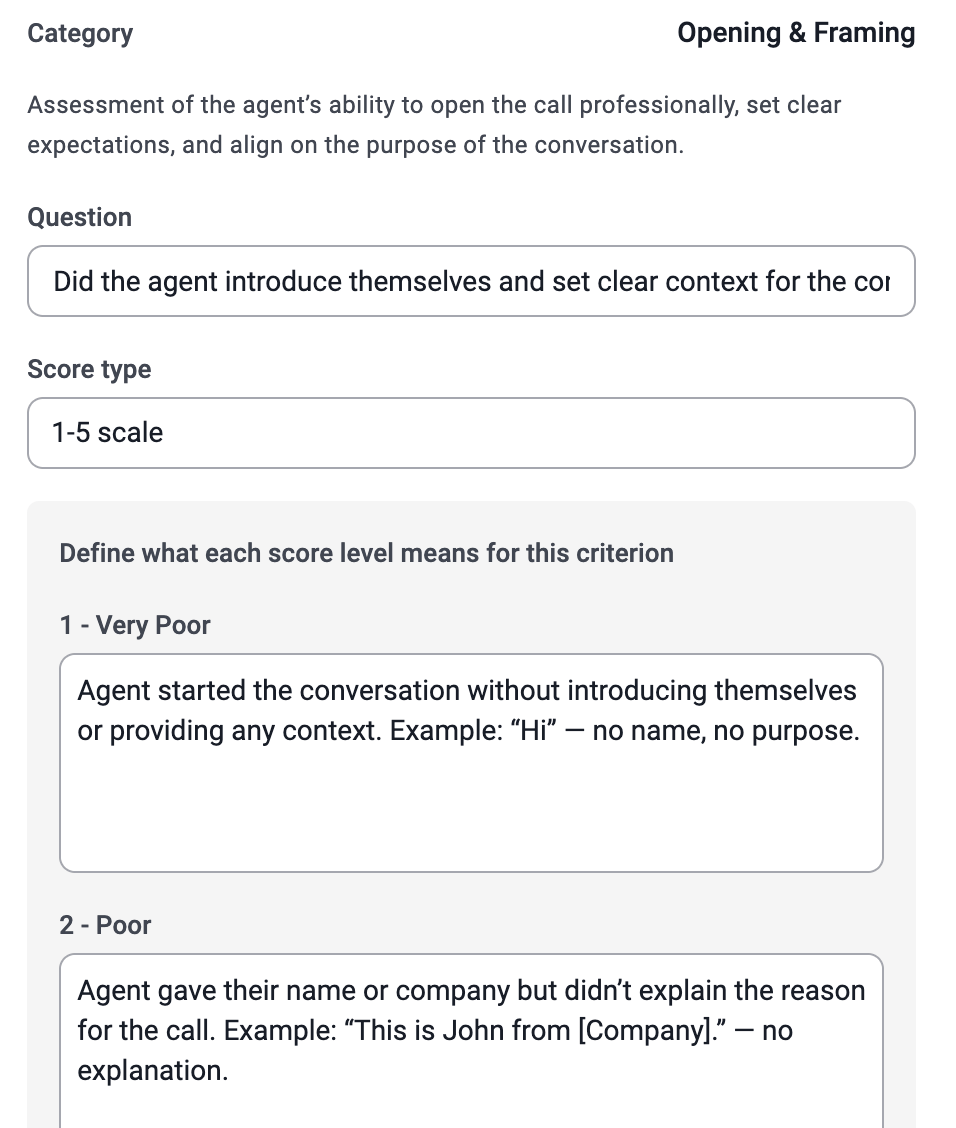
Escala de 5 pontos (Muito Fraco → Muito Bom)
- Defina o que significa cada nível.
- Indique pelo menos um exemplo para Muito Fraco (1) e Muito Bom (5).
- Os níveis intermédios (Fraco, Razoável, Bom) também podem ter exemplos (recomendado).
-
Exemplo:
- Muito Fraco (1): «O agente não explorou de todo as necessidades do cliente. Exemplo: “Deixe-me mostrar-lhe o que oferecemos.”»
- Muito Bom (5): «O agente explorou aprofundadamente a situação do cliente com perguntas de seguimento. Exemplo: “Como é o seu processo atual? Que desafios enfrenta?”»
Aplicar modelos
Até 10 modelos de pontuação por conta. Um modelo é aplicado a uma chamada de uma de três formas:- Padrão: um dos modelos é o padrão da conta e é utilizado em qualquer chamada que não seja encaminhada através de um grupo nem atendida por um Voice Agent abrangido por outro modelo. Defina-o nas Definições do modelo com Definir como modelo padrão para chamadas sem correspondência. Só um modelo pode ser o padrão de cada vez. As contas novas começam com o modelo de pontuação padrão da CloudTalk (10 perguntas).
- Manualmente: um modelo pode ser aplicado a uma chamada a partir dos Detalhes de chamada.
- Atribuição automática: abra o modelo e, em Definições, utilize Aplicar a grupos e Aplicar a Voice Agents para escolher as chamadas de quem deve pontuar. Um grupo ou Voice Agent só pode pertencer a um modelo de cada vez. Cada chamada é associada automaticamente ao modelo do grupo ou do Voice Agent que a atendeu. Tudo o que não tiver correspondência recorre ao modelo padrão. No CI Basic, um modelo com uma atribuição de grupo guardada apresenta um selo Requer CI Plus e essas chamadas são pontuadas com o modelo padrão.

Mostrar pontuações de chamada aos agentes
É uma opção nas definições de Pontuação de Chamada. Está desativada por predefinição e aplica-se a toda a conta (não por agente).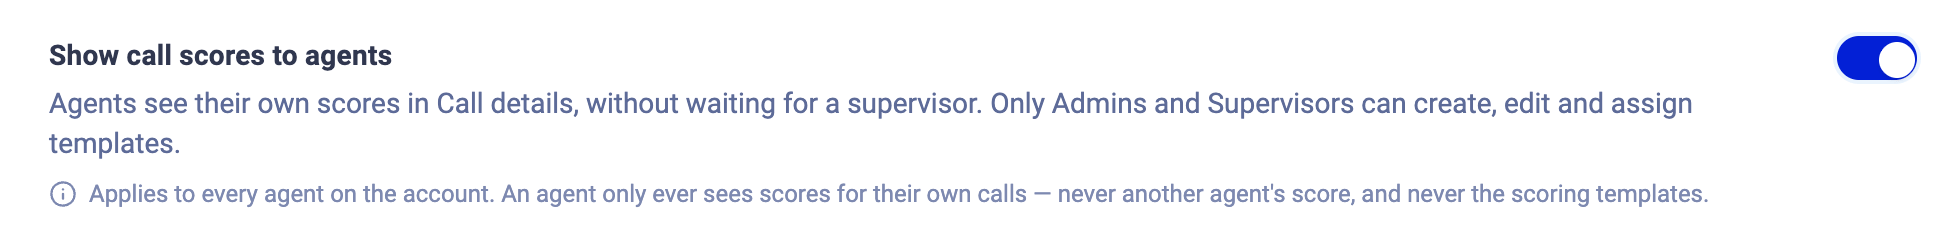
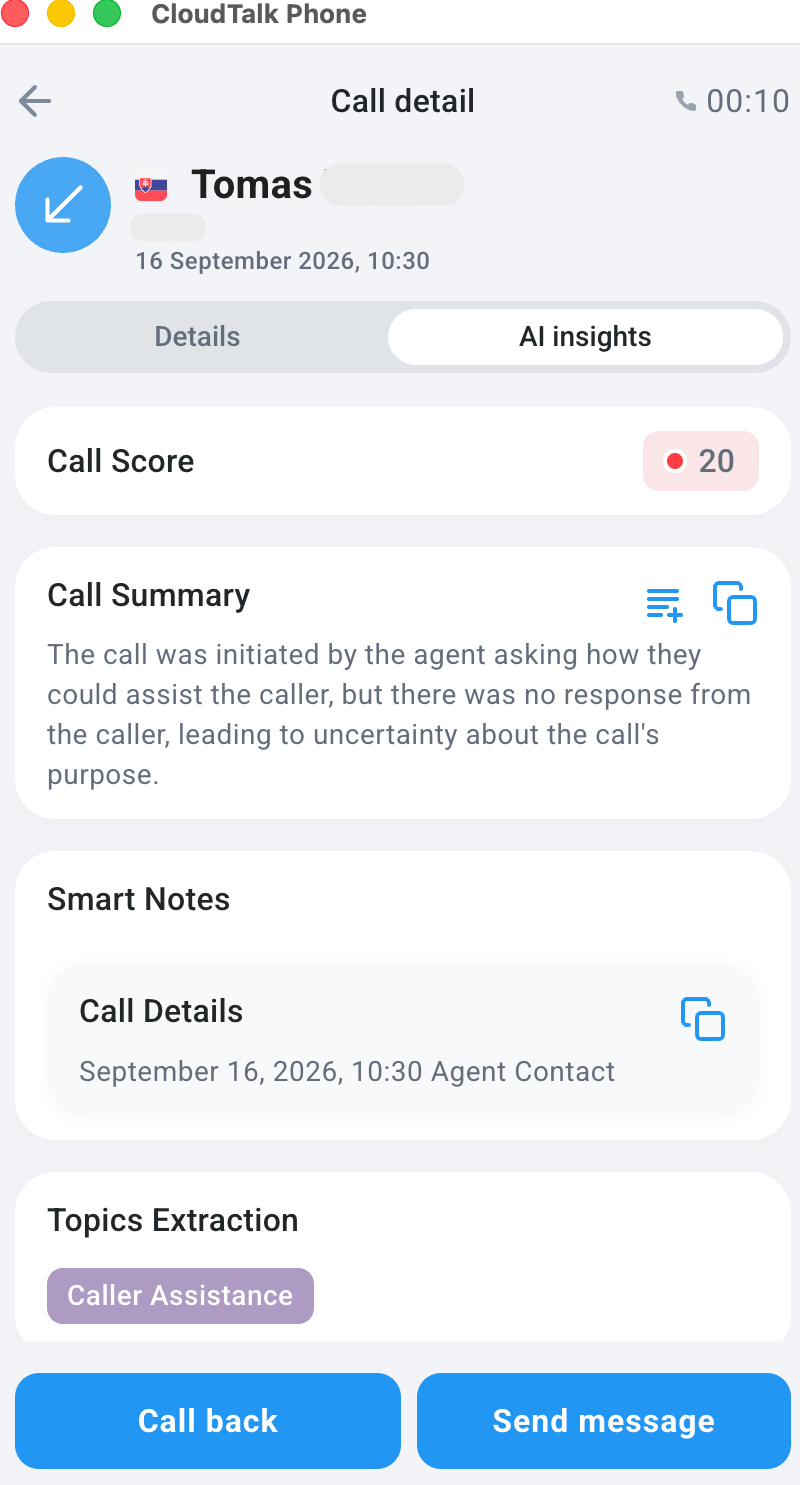
- Ativar: um agente com o CI ativado vê a pontuação nos Detalhes de chamada das chamadas em que participou. Um agente vê sempre apenas as pontuações das suas próprias chamadas, nunca a pontuação de outro agente e nunca os modelos de pontuação.
- Desativar: a pontuação não é mostrada aos agentes.
- Os restantes dados de CI nos Detalhes de chamada (transcrição, resumo, notas inteligentes, tópicos, rácio de fala/escuta, sentimento) continuam visíveis para os agentes sempre que o CI estiver ativado no respetivo utilizador, independentemente desta definição.
Onde encontrar esta funcionalidade na CloudTalk
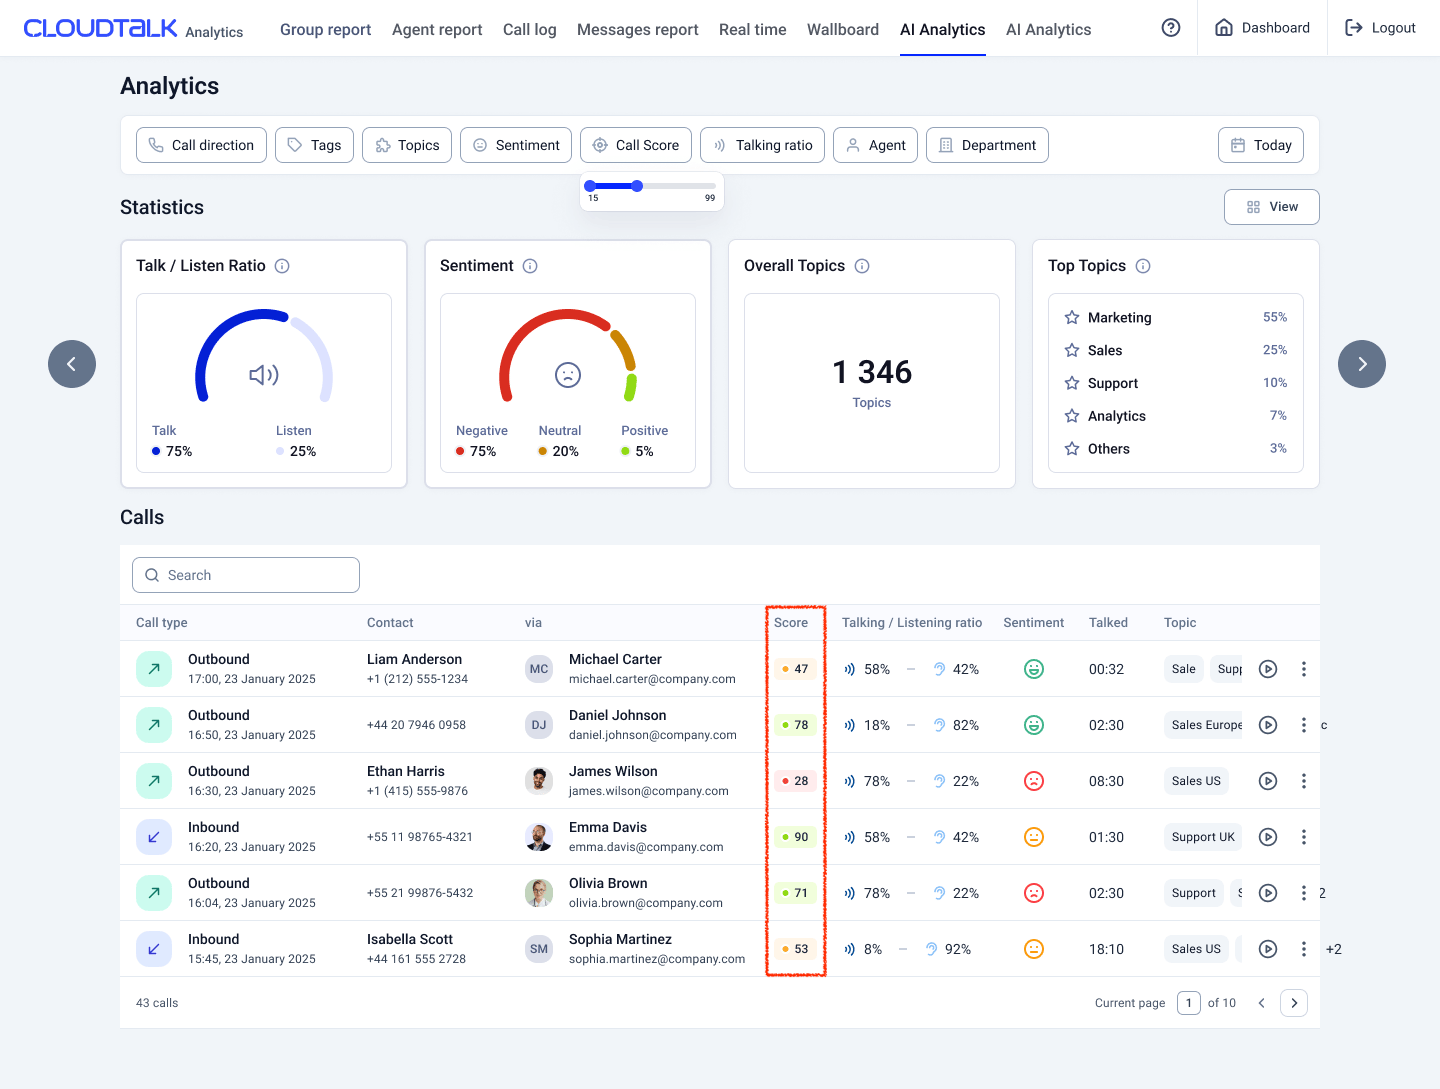
- Aceda a Analytics > AI Analytics.
-
Na lista, cada chamada apresenta um selo de Pontuação juntamente com o rácio de fala/escuta, o Sentimento, os Tópicos e muito mais.
-
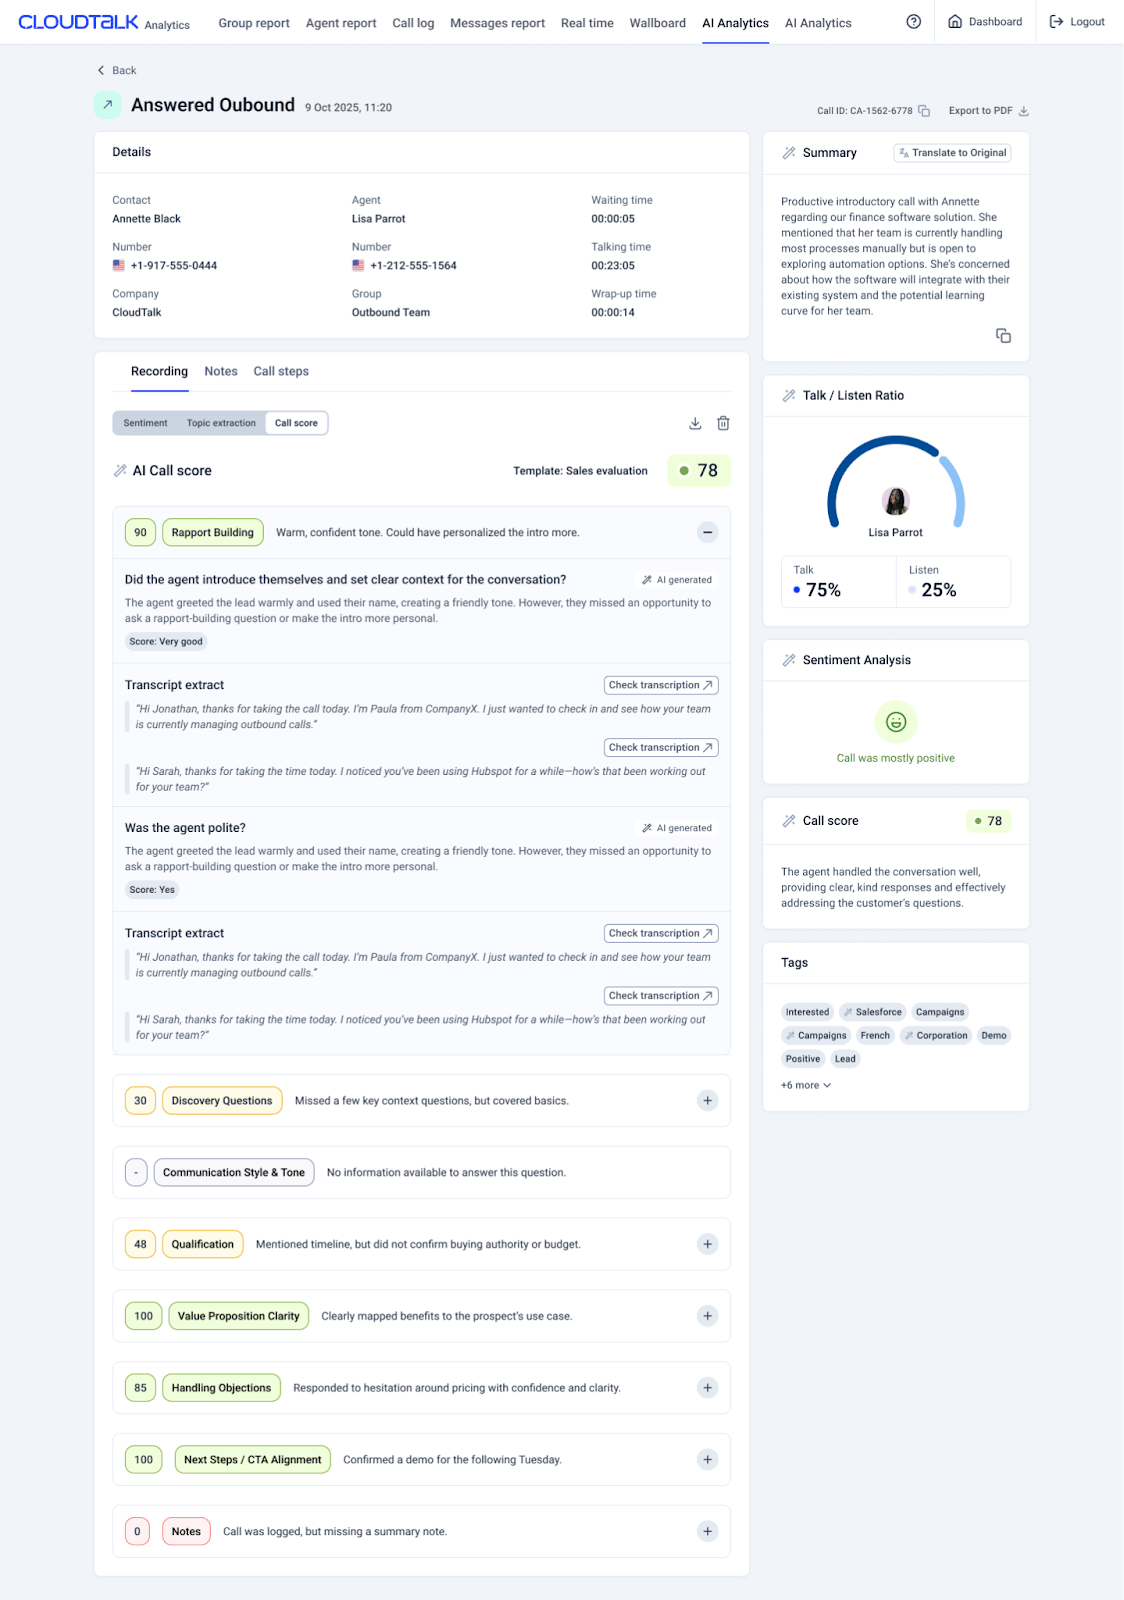
Clique nos três pontos à direita de qualquer linha para abrir os Detalhes de chamada e, em seguida, selecione o separador Pontuação da chamada para ver a análise completa.
No separador Pontuação da chamada encontra:
- Pontuações por secção com as respetivas etiquetas (Abertura e Enquadramento, Gestão de Objeções).
- Um breve resumo escrito pela IA para cada pergunta, a explicar porque foi atribuída aquela pontuação.
- Excertos da transcrição ligados diretamente ao momento relevante da chamada (clique em «Consultar transcrição» para ir diretamente para esse ponto).
- A pontuação global no topo, com base no seu modelo.
Como funciona a pontuação
Baseada em modelos
Cada pontuação baseia-se num modelo de pontuação. O modelo que pontua uma chamada é aquele que a abrange: o seu modelo padrão, um modelo aplicado manualmente a partir dos Detalhes de chamada ou o modelo atribuído automaticamente ao grupo ou ao Voice Agent que atendeu a chamada.- Um modelo é composto por secções fixas (por exemplo, Abertura e Enquadramento, Descoberta e Análise de Necessidades, Proposta de Valor e Adequação da Solução, Gestão de Objeções, Fecho e Próximos Passos, Tom e Empatia).
- Dentro de cada secção, acrescenta uma ou mais perguntas.
- Cada pergunta é respondida numa escala de 5 pontos, de Muito Fraco a Muito Bom. Para cada pergunta, define o que significa cada nível e acrescenta exemplos, para que a IA pontue de forma consistente de chamada para chamada.
O que acontece depois de uma chamada
- A transcrição é gerada.
- A IA aplica o modelo de pontuação que abrange a chamada.
- Para cada pergunta, procura evidências na transcrição, associa o que encontra à escala de 5 pontos e escreve uma breve justificação com um excerto da transcrição.
Pesos e cálculo
- Peso igual para as secções. Cada secção contribui com a mesma parte para a pontuação global. Um modelo com 10 secções atribui 10% a cada secção; um modelo com 5 secções atribui 20% a cada uma.
- Peso igual para as perguntas dentro de uma secção. Uma pergunta tem todo o peso da secção. Duas perguntas têm metade cada uma, e assim sucessivamente.
-
Pontuação da secção. A média das suas perguntas, arredondada para o número inteiro mais próximo.
- Secção 1 (2 perguntas): (25% + 100%) ÷ 2 = 62,5%, arredondado para 63.
- Secção 2 (2 perguntas): (100% + 0%) ÷ 2 = 50%.
- Pontuação global. A média de todas as pontuações de secção arredondadas: (63% + 50%) ÷ 2 = 57%.
Correspondência das respostas
Cada nível da escala de 5 pontos corresponde a uma percentagem:- Muito Fraco = 0%
- Fraco = 25%
- Razoável = 50%
- Bom = 75%
- Muito Bom = 100%
Tratamento de Não aplicável (N/A)
A IA devolve N/A quando não consegue pontuar uma pergunta (por exemplo, quando não existem evidências na transcrição) ou quando uma secção não tem perguntas. Os itens N/A são excluídos do cálculo e os pesos da secção e da pontuação global são recalculados apenas com as perguntas aplicáveis.O que a CloudTalk gera
Para cada chamada pontuada, obtém:- Uma pontuação global de 0 a 100.
- Uma pontuação para cada secção.
- Uma breve explicação do motivo pelo qual cada pontuação foi atribuída.
- Excertos da transcrição ligados ao momento exato da chamada, para que possa verificar as evidências por si próprio.
Boas práticas para a conceção de modelos
-
Torne os comportamentos observáveis
- Não utilize termos vagos como «Muito bom na descoberta».
- Utilize ações mensuráveis: «O agente confirma o problema do cliente numa frase.»
-
Evite perguntas dependentes do contexto
- A IA utiliza apenas a transcrição da chamada.
- Não pergunte: «O agente seguiu o guião?»
-
Mantenha o âmbito bem definido
- Poucas secções, bem delimitadas (4–7), são melhores do que muitas secções abrangentes.
-
Defina os extremos com clareza
- Indique sempre uma definição e pelo menos um exemplo para Muito Fraco (1) e Muito Bom (5).
-
Exemplo (Gestão de Objeções):
- Muito Fraco: «O agente ignorou a objeção sem a reconhecer.»
- Muito Bom: «O agente reconheceu a preocupação com empatia e reformulou-a de forma positiva.»
-
Utilize vários exemplos
- Sobretudo para Muito Fraco e Muito Bom, indique 2–3 exemplos para reduzir a ambiguidade.
-
Preveja o N/A
- O N/A é tratado pelo sistema.
- Utilize o campo de descrição para clarificar quando é expectável (por exemplo, «Não é necessária introdução numa chamada de transferência interna»).
-
Reveja os resultados com regularidade
- Ao fim de duas semanas, verifique se o seu modelo está a produzir os resultados de coaching que pretende.
- Aperfeiçoe as perguntas vagas ou acrescente melhores exemplos, se necessário.
FAQ
- A pontuação da IA afeta automaticamente o encaminhamento de chamadas ou os KPI?
Não. As pontuações destinam-se a coaching e análise.
- Quando é que a pontuação aparece?
A Pontuação da chamada é calculada juntamente com as restantes métricas da Conversation Intelligence, depois de a chamada terminar e assim que a transcrição estiver disponível
- Que funções podem ver as pontuações?
Os Administradores, os Supervisores e os Analistas podem ver os dados de pontuação no Dashboard. Os agentes veem apenas a pontuação das suas próprias chamadas e só se um Administrador tiver ativado a opção Mostrar pontuações de chamada aos agentes.
- Se as perguntas do modelo de pontuação mudarem depois de a pontuação ter sido aplicada, as chamadas são novamente pontuadas? Não. As alterações ao modelo de pontuação aplicam-se apenas às chamadas futuras. As chamadas pontuadas antes da alteração não são recalculadas.
- Posso criar perguntas personalizadas? Sim. Pode adicionar uma pergunta a partir da biblioteca predefinida e depois personalizá-la: editar o texto da pergunta e atualizar as descrições de cada nível da escala de 5 pontos. A única parte que não pode ser personalizada é a categoria, que é fixa.
-
Posso eliminar um modelo de pontuação?
Não. Para deixar de utilizar um modelo, remova as respetivas atribuições de grupos e de Voice Agents; as chamadas que abrangia passam então a utilizar o modelo padrão.
Precisa de ajuda ou tem alguma questão? Contacte-nos através do nosso portal de apoio — estamos aqui para si.